Diese Seite gibt einen kleinen Einblick in die gängigsten statistischen Methoden, die in der statistischen Beratung häufig zum Einsatz kommen. Ich erkläre kurz, worum es geht, und beschreibe häufige Missverständnisse und Fehler in der statistischen Praxis. Überdies gebe ich einen kleinen Einblick in Anwendungsbeispiele aus meinen Beratungsprojekten.
Hier ist schon einmal ein kleiner Überblick:
- klassische Hypothesentests am Beispiel des t-Tests
- die Normalverteilungsannahme
- nichtparametrische Tests wie der Mann-Whitney-U-Test
- die lineare Regression
- robuste Statistik
- Lebensdaueranalysen
- gemischte Modelle (mixed models) mit festen und zufälligen Effekten
- Metaanalysen
t-Test - der Klassiker
Bei den allermeisten statistischen Fragestellungen geht es darum zu zeigen, dass es statistisch signifikante Effekte gibt. Das können zum Beispiel Unterschiede zwischen zwei Gruppen A und B sein oder die Wirkung einer Behandlung. Sehr häufig kommt dann der t-Test zum Einsatz. In einem meiner Beratungsprojekte ging es zum Beispiel darum zu untersuchen, ob eine bestimmte Behandlung bei Operationen (Behandlungsgruppe B) den Bedarf an Schmerzmitteln in den Tagen nach der Operation reduzieren kann (im Vergleich zur Gruppe A mit Standardbehandlung).
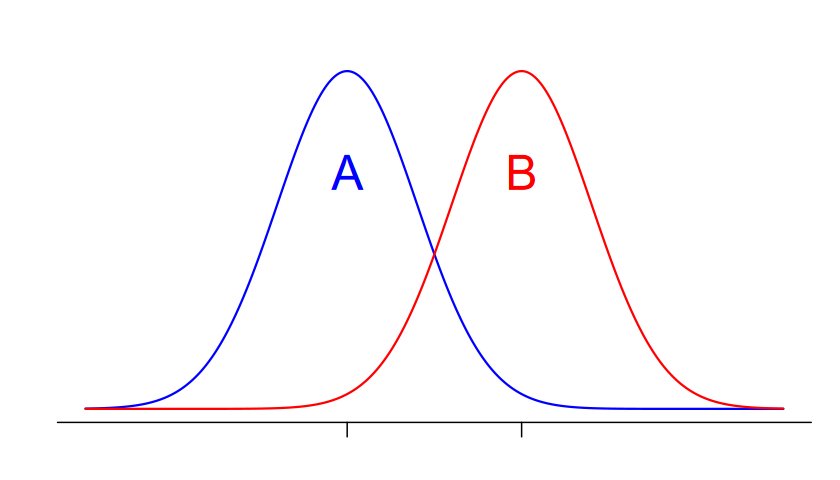
Ein häufiges Missverständnis bei solchen Gruppenvergleichen ist, dass die Daten so schön normalverteilt sein müssten wie in der Grafik. Das ist nicht ganz falsch, aber auch nicht richtig. Immerhin gibt es da ja noch den zentralen Grenzwertsatz aus der Mathematik. Dieses wirklich zentrale Gesetz ermöglicht, dass der t-Test auch ohne Normalverteilung sehr gut funktionieren kann.
Es gibt aber natürlich einige Fälle, in denen der t-Test nicht anwendbar ist:
- Die Daten sind sehr schief verteilt und es gibt erhebliche Ausreißer. Dann sollten nichtparametrische Alternativen bzw. Methoden der robusten Statistik zum Einsatz kommen.
- Es müssen weitere Kontrollvariablen (wie z.B. der Gesundheitszustand von Patienten) berücksichtigt werden. Dann kann z.B. die lineare Regression zum Einsatz kommen.
- Die Daten sind gepaart bzw. es liegen Messwiederholungen vor. Dies ist zum Beispiel der Fall, wenn die Messungen zu A und die Messungen zu B nicht an zwei getrennten Gruppen durchgeführt wurden, sondern wenn Messungen vor einer Behandlung (A) mit Messungen nach einer Behandlung (B) bei den jeweils selben Personen verglichen werden sollen. Dann können neben Tests für gepaarte Stichproben zum Beispiel auch gemischte Modelle (mixed models) zum Einsatz kommen.
Sie sehen also, dass es in jedem Fall eine Alternative gibt. Interessant wird es jedoch, wenn die eben genannten Punkte zusammen in Kombination auftreten. Dann ist wirklich ein tieferer Griff in die Methodenkiste nötig und genau zu überlegen, wie die Fragestellung am besten statistisch sauber bearbeitet werden kann.
Normalverteilungsannahme prüfen
Wohl kaum ein anderer Bereich der Statistik ist stärker von Missverständnissen geprägt als das Thema der Normalverteilungsannahme. Generell wird die Bedeutung der Normalverteilungsannahme vielfach überschätzt. Dank des zentralen Grenzwertsatzes kommt es nicht darauf an, dass die Daten wirklich normalverteilt sind. Die Daten dürfen nur nicht zu schief verteilt sein und es darf keine allzu schlimmen Ausreißer geben. Aus diesem Grund sind Normalverteilungs-Tests wie der Shapiro-Wilk-Test kaum geeignet um die Anwendbarkeit zum Beispiel eines t-Tests zu prüfen. Der Test prüft nicht das, worauf es ankommt. Folglich bedeutet ein signifikantes Ergebnis beim Shapiro-Wilk-Test nicht automatisch, dass eine nichtparametrische Alternative zum t-Test verwendet werden muss. Andererseits bedeutet ein nicht-signifikantes Ergebnis beim Shapiro-Wilk-Test keineswegs, dass der t-Test bedenkenlos anwendbar wäre.
In der Folge sehe ich häufig, dass der t-Test in Situationen verwendet wird, in denen dies kaum vertretbar ist. Und umgekehrt werden nichtparametrische Tests verwendet, obwohl es unnötig ist. Dies liegt nicht zuletzt an einer häufig ganz falschen Durchführung der Normalverteilungsprüfung, wie wir im Folgenden sehen werden.
Statistisch gesehen ergibt die Kreuzung aus zwei Dromedaren ein Kamel
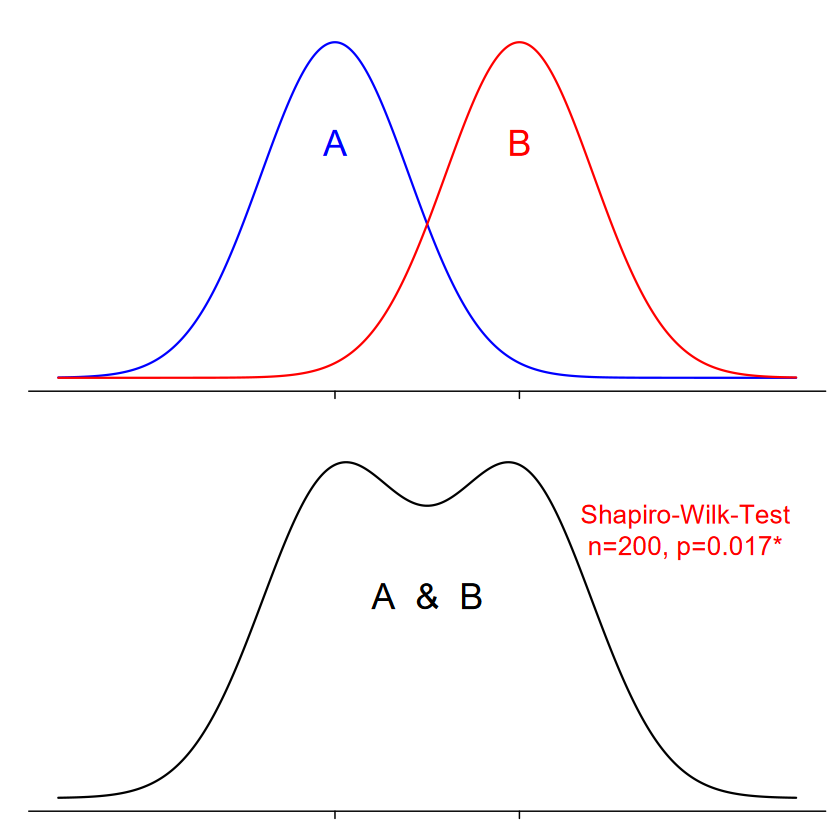
Sehen wir uns die Situation aus dem Abschnitt zum t-Test an. Dies ist eine Situation wie aus dem Bilderbuch: Es gibt eine Gruppe A (blaue Verteilungskurve) mit wunderschön normalverteilten Werten und eine Gruppe B (rote Verteilungskurve) mit ebenso wunderschön normalverteilten Werten. Überdies gibt es einen deutlichen statistisch signifikanten Effekt. Die rote Gruppe B hat im Durchschnitt deutlich höhere Werte als die blaue Gruppe A. Besser kann man es sich als Doktorand:in nicht wünschen! Der t-Test ist in dieser perfekten Situation selbstverständlich anwendbar.
Wenn man jetzt die Daten jedoch gemeinsam betrachtet, dann ist die Gesamtverteilung nicht normalverteilt, der Shapiro-Wilk-Test lehnt die Normalverteilung mit einem signifikanten p-Wert von 0.017 ab. Den Grund sieht man sehr schön in der Grafik: Wenn man zwei Verteilungen mit jeweils einem Gipfel (Dromedare) mischt, dann erhält man eine Verteilung mit zwei Gipfeln (Kamel). Die Normalverteilung muss getrennt für die beiden Gruppen A und B geprüft werden, nicht auf dem Gesamtdatensatz!
Praxistipp: grafische Überprüfung
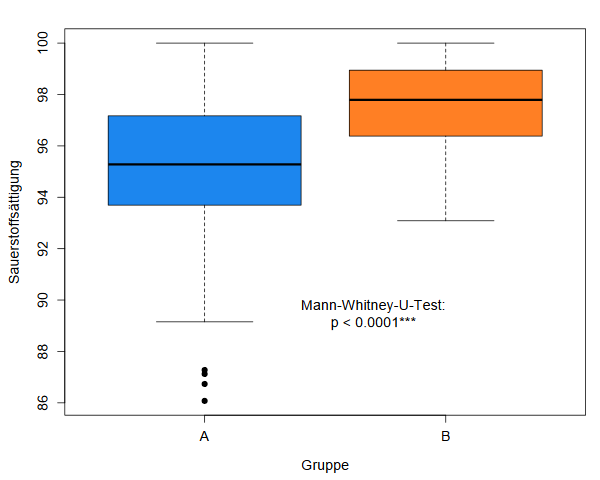
Tests auf Prüfung der Normalverteilungsannahme sind kaum geeignet, um die Anwendbarkeit von klassischen Tests, wie zum Beispiel dem t-Test zu prüfen. Besser sind grafische Methoden, da hier direkt und gezielt die tatsächlich relevanten Abweichungen von der Normalverteilung geprüft werden können. Dies sind vor allem Ausreißer und eine zu große Schiefe der Verteilung. Hierfür eignen sich zum Beispiel ganz wunderbar Boxplots und Histogramme, wie Sie hier an einem Praxisprojekt sehen können, in dem ich unter anderem die Sauerstoffsättigung von Patienten untersucht habe.
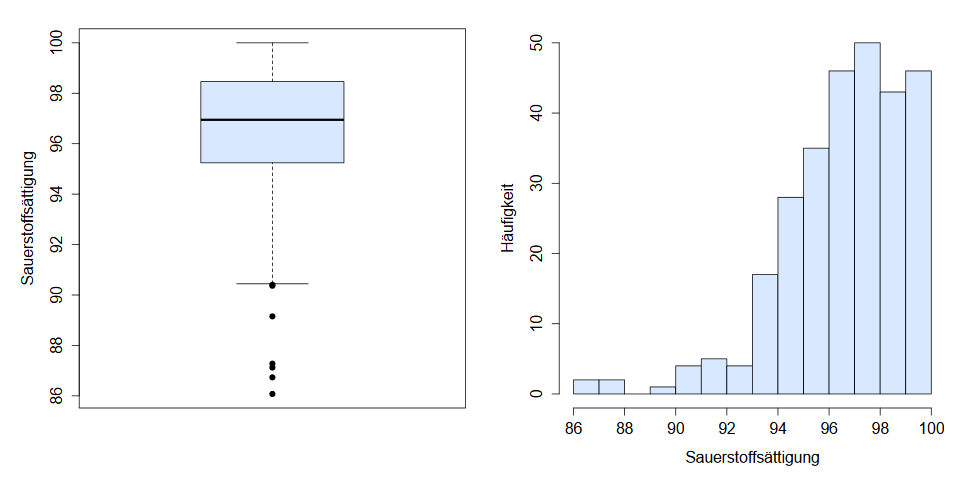
Die Sauerstoffsättigung ist ein Beispiel für eine natürlicherweise schiefe Verteilung: Die Sauerstoffsättigung beträgt maximal 100% und die meisten Personen haben eine Sauerstoffsättigung, die nahe bei 100% liegt, aber es gibt einige wenige deutliche Abweichungen nach unten. In diesem Fall wäre die Verwendung von klassischen statistischen Verfahren, wie zum Beispiel dem t-Test, nicht vertretbar. Stattdessen können nichtparametrische Alternativen zum Einsatz kommen.
Nichtparametrische Tests
Klassische Tests wie der t-Test sind nicht geeignet, wenn die Daten schief verteilt sind oder es zu große Ausreißer gibt. In diesen Fällen können nichtparametrische Tests als Alternativen zum Einsatz kommen. Die wichtigsten nichtparametrischen Tests sind
- der Mann-Whitney-U-Test als Alternative zum t-Test (bei ungepaarten Stichproben)
- der Wilcoxon-Vorzeichen-Rangtest als Alternative zum gepaarten t-Test
- der Kruskal-Wallis-Test bei Mehrstichprobenvergleichen als Alternative zum ANOVA-F-Test
Mann-Whitney-U-Test
Für eine Doktorarbeit in der Medizin habe ich die Sauerstoffsättigung von zwei verschiedenen Gruppen untersucht. Ein solcher Gruppenvergleich sollte grundsätzlich zunächst grafisch erfolgen. In den Boxplots sieht man zum einen, dass die Daten einigermaßen schief verteilt sind und es (zumindest in Gruppe A) auch Ausreißer gibt. Zum anderen sieht man sehr schön, dass in Gruppe B die Sauerstoffsättigung deutlich höher ist als in Gruppe A. Dies hat auch der Mann-Whitney-U-Test mit einem hochsignifikanten p-Wert bestätigt.
Wenn Sie Unterstützung bei der statistischen Auswertung für Ihre Doktorarbeit benötigen, können Sie sich hier informieren.
Lineare Regression
Die lineare Regression ist mit Sicherheit das Blockbuster-Verfahren der Statistik! Ein Grund dafür ist die Vielfalt der Einsatzmöglichkeiten. Die lineare Regression wird in wissenschaftlich orientierten Datenanalysen angewendet, wenn der Zusammenhang zwischen mehreren Einflussvariablen (unabhängige Variablen) und einer Zielvariable (abhängige Variable) untersucht werden soll. Dies ist insbesondere dann der Fall, wenn nicht nur ein einfacher Vergleich zwischen zwei Gruppen durchgeführt werden soll, sondern wenn dabei auch weitere Kontrollvariablen (z.B. Alter und Geschlecht) berücksichtigt werden sollen. Aber auch für Unternehmen spielt die lineare Regression eine herausragende Rolle, wenn es darum geht Prognosen zu berechnen (Predictive Analytics). Auch in Zeiten von KI und maschinellem Lernen ist die lineare Regression mit Sicherheit immer noch das am häufigsten verwendete Predictive Analytics Verfahren. Wenn Sie Predictive Analytics für Ihr Unternehmen nutzen wollen und hierfür Unterstützung benötigen, können Sie sich hier informieren.
Nicht zuletzt kommt man auch im Alltagsleben immer wieder mit den Ergebnissen von linearen Regressionen in Berührung ohne es vielleicht zu merken. Ein Beispiel hierfür ist der Mietspiegel, den ich zusammen mit einem Kollegen für die Stadt Deggendorf erstellt habe.
Projektbeispiel: Deggendorfer Mietspiegel
Ein Mietspiegel dient zur Ermittlung der sogenannten ortsüblichen Vergleichsmiete. Wenn Sie als Mieter wissen wollen, ob die Ihnen angebotene Wohnung preislich im Rahmen ist, dann können Sie dies anhand des örtlichen Mietspiegels überprüfen. Oder wenn Sie als Vermieterin eine Wohnung vermieten wollen, dann können Sie sich für die von Ihnen veranschlagte Miete ebenfalls am Mietspiegel orientieren. Das sollten Sie sogar unbedingt tun, denn für Mieterhöhungen gibt es rechtliche Einschränkungen und diese werden durch den Mietspiegel definiert. Ein qualifizierter Mietspiegel wie der Deggendorfer Mietspiegel ist also auch für gerichtliche Auseinandersetzungen von entscheidender Bedeutung.
Wie ein Mietspiegel entsteht
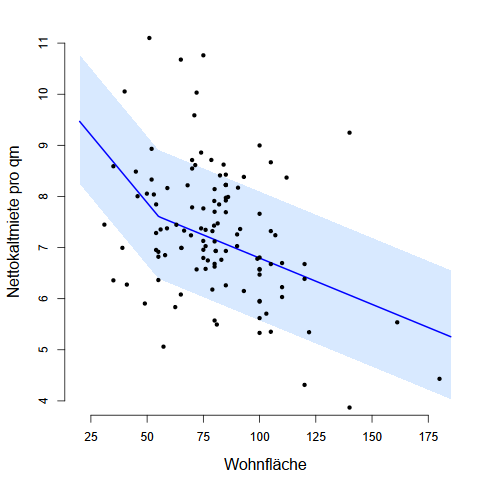
Für einen Mietspiegel wird zunächst eine repräsentative Stichprobe von Mietwohnungen gezogen. Anschließend werden die Mieter:innen (oder seltener auch die Vermieter:innen) über die Beschaffenheit der Wohnung sowie die aktuelle Miete befragt.
Welche Miete für eine Wohnung gezahlt wird, hängt natürlich stark von einer Reihe von Einflussfaktoren ab. Dazu gehören zum Beispiel die Lage, das Baujahr, die Größe und besondere Ausstattungsmerkmale (wie z.B. ein Balkon oder eine Fußbodenheizung). Und damit sind wir genau in der Situation einer linearen Regression: Mit Hilfe der Daten aus der repräsentativen Stichprobe setzt die lineare Regression diese Einflussfaktoren in Beziehung zur Miete (Nettokaltmiete pro Quadratmeter). Ergebnis ist dann beispielsweise ein für alle Bürgerinnen und Bürger nutzbarer Online-Rechner zur Ermittlung der durchschnittlichen Miete (ortsübliche Vergleichsmiete).
Robuste Statistik
Viele klassische statistische Verfahren reagieren empfindlich auf Ausreißer und Abweichungen von Modellannahmen. Ein Grund dafür ist, dass viele statistische Verfahren auf Berechnungen des Mittelwerts und der Standardabweichung beruhen, wie zum Beispiel der t-Test, der Pearson-Korrelationskoeffizient und die lineare Regression. Aus diesem Grund befasst sich ein Teilgebiet der Statistik mit der Entwicklung von sogenannten robusten Verfahren – also Verfahren, die nicht ganz so empfindlich gegenüber Ausreißern und Modellabweichungen sind. Ich habe zum Beispiel im Jahr 2006 meine Diplomarbeit über eine robuste Alternative zur Cox-Regression in der Lebensdaueranalyse verfasst. Die Ergebnisse sind auch in einer wissenschaftlichen Fachzeitschrift erschienen.
Folgende Grafiken zeigen das Beispiel eines Datensatzes, für den die lineare Regression (rote Linie) aus drei Gründen nicht ohne Weiteres anwendbar ist:
- In den Daten gibt es zahlreiche Ausreißer.
- Sowohl aus dem Streudiagramm (links) als auch dem Residuenplot (rechts) ist ersichtlich, dass die Fehlerverteilung nicht symmetrisch, sondern sehr schief ist.
- Ebenfalls aus beiden Plots ist ersichtlich, dass die Varianz in y-Richtung von den x-Werten abhängt: Je höher der x-Wert, desto größer die Varianz beim y-Wert (Heteroskedastizität).
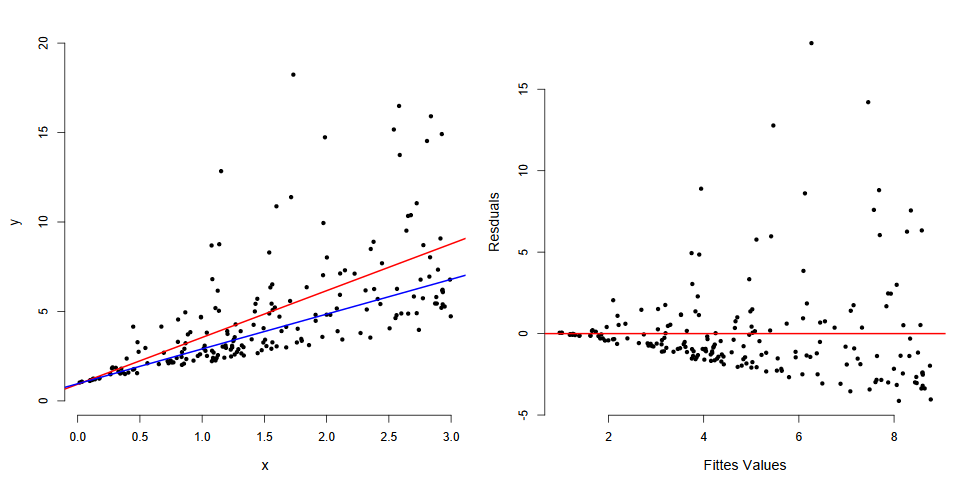
Die rote Linie im linken Streudiagramm stellt das Ergebnis der linearen Regression grafisch dar. Man sieht, dass aufgrund der Ausreißer die Steigung der roten Regressionsgerade zu groß ist. Das Ergebnis der linearen Regression ist fehlerhaft, was sich auch eindrücklich im dazugehörigen Residuenplot (rechte Grafik) zeigt. Aus den genannten drei Gründen ist die lineare Regression hier nicht anwendbar. Eine häufige Lösungsmöglichkeit besteht darin, die y-Werte zu logarithmieren. Diese Standard-Lösung ist jedoch gar nicht so empfehlenswert, wie oftmals angenommen: Zum einen löst es das Problem meist nur so halbwegs gut; auch nach Logarithmierung ist die Fehlerverteilung oft immer noch nicht so richtig symmetrisch. Zum anderen sind die Ergebnisse nach der Logarithmierung deutlich schwerer interpretierbar.
Eine andere Möglichkeit als das Herumdoktern an der Verteilung ist es, das Übel an der Wurzel zu packen: Die lineare Regression beruht auf dem Mittelwert und der Mittelwert ist für schiefe Verteilungen gänzlich ungeeignet. Eine robuste Alternative zum Mittelwert ist der Median. Was liegt also näher als die Berechnung einer Alternative zur linearen Regression, die nicht auf dem Mittelwert, sondern auf dem Median beruht? Die blaue Linie zeigt die Regressionsgerade einer solchen Medianregression. Die blaue Linie verläuft deutlich flacher und gibt den Zusammenhang zwischen x und y korrekt wieder.
Leider werden die Möglichkeiten der robusten Statistik aus Unwissenheit viel zu selten genutzt. Ich sehe häufig in statistischen Auswertungen, dass versucht wird, die Daten mit Transformationen hin und her zu biegen. Am Beispiel der (weithin unbekannten) Medianregression wollte ich hier nur zeigen, dass die Statistik so gut wie immer noch sehr viel mehr (und bessere) Lösungsmöglichkeiten zu bieten hat.
Lebensdaueranalysen (Survival Analysis)
Lebensdaueranalysen spielen in der Medizin eine große Rolle. Ich habe aber auch schon Lebensdaueranalysen für elektronische Komponenten in der Automobilindustrie durchgeführt. Eine der häufigsten Anwendungen von Lebensdaueranalysen in der Medizin ist sicherlich die Untersuchung der Überlebensraten von Krebspatient:innen. Es geht aber auch bei medizinischen Themen nicht immer um Leben und Tod. In einer meiner statistischen Beratungen ging es zum Beispiel um die Lebensdauer von Zahnimplantaten, in einem anderen Fall um die Lebensdauer eines Katheters.
Lebensdaueranalysen waren schon Thema meiner Diplomarbeit (vgl. die hier verlinkte wissenschaftliche Publikation). Ein typisches Problem von Lebensdaueranalysen ist, dass die Daten vielfach zensiert sind. Das Problem zensierter Daten versteht man am besten am konkreten Beispiel: Bei der Untersuchung zur Lebensdauer von Zahnimplantaten kam es vor, dass
- Zahnimplantate bei Studienende noch intakt waren,
- Patient:innen im Lauf der Langzeitstudie verstarben oder
- Patient:innen aus anderen Gründen vorzeitig aus der Studie ausschieden (wobei das Zahnimplantat zu diesem Zeitpunkt noch intakt war).
Alle drei Fälle haben eines gemeinsam: In allen drei Fällen weiß man nicht, wie lange das Implantat gehalten hätte, man kennt nur eine Mindestüberlebensdauer. Die Daten sind zensiert! Einfache Durchschnittsberechnungen sind bei zensierten Daten natürlich nicht angebracht, denn die Zensierung der Daten würde das Ergebnis verfälschen. Es ist (in der Regel) auch keine Option, die zensierten Fälle einfach aus den Daten zu entfernen, denn das kann zu erheblichen Verzerrungen führen. Am deutlichsten sieht man das im Fall der Zahnimplantate, die bei Studienende noch intakt waren. Würde man diese Fälle aus den Daten entfernen, dann würde man ja systematisch gerade die langlebigsten Implantate aus den Daten entfernen.
Bei Lebensdaueranalysen mit zensierten Daten braucht es ausgefallenere Methoden. Von besonderer Bedeutung sind hierbei der Kaplan-Meier-Schätzer und die Cox-Regression.
Kaplan-Meier-Schätzer
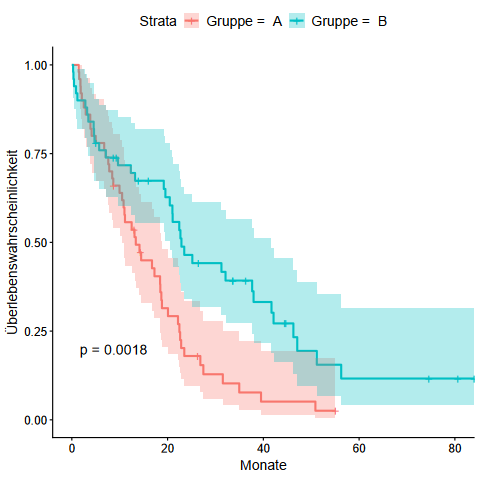
Die Grafik zeigt die Überlebenskurven für zwei Gruppen. Die Überlebenskurven wurden mit Hilfe des Kaplan-Meier-Schätzers berechnet. Dieses Verfahren wurde speziell für Überlebensdauern entwickelt und berücksichtigt auch zensierte Daten korrekt.
Man sieht in diesem Beispiel sehr schön, dass die Überlebenskurve der Gruppe B (in grün) deutlich oberhalb der Überlebenskurve der Gruppe A (in rot) liegt. Das heißt, in der Gruppe B ist die Überlebenswahrscheinlichkeit zu jedem Zeitpunkt höher als in der Gruppe A. Dieser Unterschied ist hier mit einem p-Wert von p=0.0018 sogar hoch-signifikant.
Mixed Model für Daten mit Messwiederholung
Stellen Sie sich folgende Situation vor: Sie testen die Wirkung eines Blutdruckmedikaments. Eine Gruppe von Personen erhält dieses Medikament (wohingegen die Kontrollgruppe ein Placebo erhält). Die Patienten kommen nun zwei Monate lang jeweils einmal pro Woche zu Ihnen zur Blutdruckmessung. Nun möchten Sie den zeitlichen Verlauf der Blutdruckmessungen (im Unterschied zur Kontrollgruppe) analysieren. Nun haben Sie es mit Daten mit Messwiederholung zu tun: An jeder Person werden mehrere Messungen durchgeführt, wobei die zu einer Person gehörenden Einzelmessungen natürlich voneinander abhängen. (Eine Person mit generell sehr hohem Blutdruck wird tendenziell immer höhere Blutdruckwerte haben als eine Person mit generell niedrigerem Blutdruck.) Die allermeisten statistischen Methoden setzen stochastische Unabhängigkeit voraus: Das heißt, jede Einzelmessung wurde an einer anderen Person durchgeführt und es gibt keinerlei Abhängigkeiten zwischen den einzelnen Messungen. Alle diese Methoden sind nun in Ihrer Situation nicht anwendbar.
Da Daten mit Messwiederholungen keine besonders exotische Situation sind, gibt es schon lange entsprechende Verfahren, die speziell für solche Situationen geeignet sind. Das berühmteste Beispiel ist sicher der gepaarte t-Test für jeweils zwei Messungen (z.B. prä vs. post). Einige der eher klassischerweise verwendeten Verfahren unterliegen jedoch recht starren Voraussetzungen. Nun kann es jedoch sein, dass manche Patient:innen nicht alle Kontrolltermine wahrnehmen können. Das heißt, die Anzahl der Messungen ist nicht für jeden Patienten identisch. Auch kann es natürlich sein, dass der zeitliche Abstand zwischen zwei Messungen nicht immer exakt eine Woche beträgt. Um solche Gegebenheiten korrekt berücksichtigen zu können, werden heutzutage zunehmend sogenannte Mixed Models (gemischte Modelle) verwendet. Hierbei handelt es sich um Regressionsmodelle mit festen und zufälligen Effekten.
Zufällige Effekte (random effects)
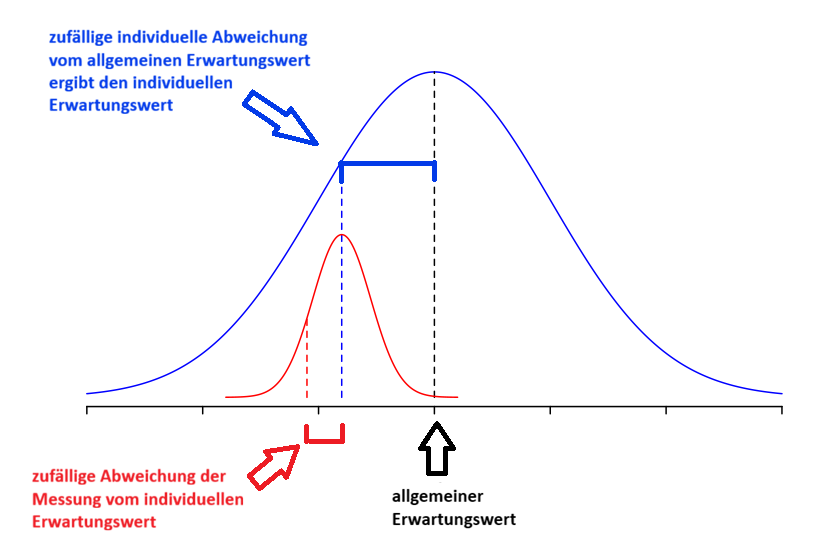
Die meisten statistischen Modelle beruhen auf dem Gedanken einer einmaligen Zufallziehung: Es gibt einen allgemeinen theoretisch gültigen Erwartungswert. Die Blutdruckmessung an einem Patienten entspricht dann einer Zufallsziehung: der gemessene Wert ist eine zufällige Abweichung des allgemeinen theoretisch gültigen Erwartungswertes für den Blutdruck.
Bei einem Mixed Modell wird dieser Gedanke nun auf eine zweifache Zufallsziehung erweitert: Jeder Patient besitzt einen individuellen Erwartungswert für den Blutdruck, der zufällig vom allgemeinen Erwartungswert abweicht. Dieser individuelle Erwartungswert ist gedanklich das Ergebnis der 1. Zufallsziehung (der sogenannte zufällige Effekt oder random effect; dargestellt durch die große blaue Normalverteilungskurve in der Grafik). Wenn man bei einer Person jedoch mehrfach den Blutdruck misst, dann wird das Ergebnis nicht stets identisch sein. Das Ergebnis einer jeden Messung weicht abermals zufällig vom individuellen Erwartungswert ab. Diese Abweichung der einzelnen Messung ist gedanklich das Ergebnis der 2. Zufallsziehung (dargestellt durch die kleine rote Normalverteilungskurve in der Grafik).
Metaanalyse
Oftmals gibt es zu einem Thema nicht nur eine wissenschaftliche Studie, sondern eine Vielzahl an Studien, die möglicherweise zu widersprüchlichen Ergebnissen kommen. So gibt es zum Beispiel zahlreiche Studien, die positive Effekte von Milchkonsum aufzeigen, aber es gibt auch zahlreiche Studien, die keinen Effekt oder sogar negative Effekte zeigen. Was stimmt denn nun?
Um hierzu zu einer Antwort zu kommen, ist die Gesamtschau der Studienlage wichtig. Dabei werden in einer Metaanalyse die Ergebnisse der einzelnen Studien statistisch analysiert und zusammengefasst. Die Grundidee der hierfür verwendeten statistischen Methoden ist folgendermaßen: Jede Studie wird an zufällig ausgewählten Personen durchgeführt. Das Ergebnis der Studie hängt also von dieser Zufallsstichprobe ab und die statistische Analyse innerhalb dieser Studie trägt (z.B. bei der Berechnung der p-Werte) diesen Zufallseffekten Rechnung. Wenn man sich jedoch mehrere Studien zu einem Thema ansieht, dann stellt man fest, dass die Studien zu einem Thema niemals identisch durchgeführt werden. Die Studien wurden evtl. in verschiedenen Ländern und von verschiedenen Ärzten durchgeführt. Dabei gibt es sowohl bei der Behandlung als auch bei der Erhebung der Daten möglicherweise kleinere Unterschiede. All das führt dazu, dass sich nicht nur die einzelnen Patienten innerhalb einer Studie zufällig unterscheiden, sondern auch die Studien untereinander. Gedanklich handelt es sich also um eine zweifache Zufallsziehung. Die erste Zufallsziehung bezieht sich auf eine Einzelstudie als Ganzes. Diese Einzelstudie unterliegt einer studienspezifischen zufälligen Abweichung vom Idealwert. In der zweiten Zufallsziehung werden dann für jede Studie zufällig die Studienteilnehmer bestimmt.
Aufmerksame Leserinnen und Leser fühlen sich nun vielleicht an den Ausführungen zu Mixed Models erinnert – und das völlig zurecht! Moderne Metaanalysen nutzen nämlich genau die Technik der Mixed Models, wobei die zufälligen studienspezifischen Abweichungen die sogenannten random effects darstellen.
Projektbeispiel: Hüftoperation
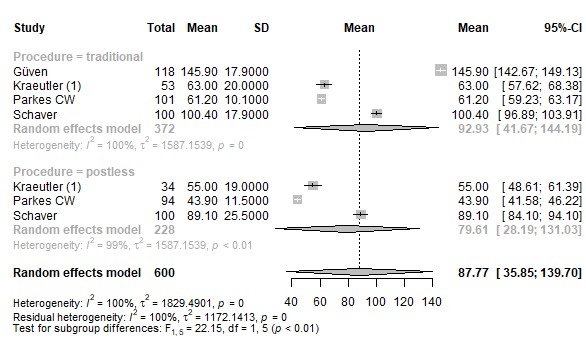
Zusammen mit Kollegen vom Universitätsklinikum Brandenburg und dem Klinikum Rechts der Isar der TU München habe ich eine Metaanalyse durchgeführt, in der wir eine neue Methode zur Hüftarthroskopie untersucht haben.
In dem hier dargestellten Forestplot konnten wir zeigen, dass die neue Methode („Procedure = postless“) hochsignifikant kürzere Operationszeiten erlaubt als die traditionelle Operationsmethode („Procedure = traditional“). Die vollständige Arbeit ist als Open Access Artikel in Knee Surgery, Sports Traumatology, Arthroscopy publiziert.
Wenn Sie ebenfalls biostatistische Unterstützung für Ihre klinische Forschung benötigen, können Sie sich hier informieren.
Maschinelles Lernen / KI
Neben meiner Tätigkeit in der statistischen Beratung bin ich als Professor für Künstliche Intelligenz (mit dem Schwerpunkt Maschinelles Lernen) an der Technischen Hochschule Deggendorf berufen. Hier stelle ich Ihnen eines meiner Vorlesungsskripte zum maschinellen Lernen zur Verfügung. Dieses können Sie sehr gerne nach Belieben für Ihre Zwecke nutzen:
In dem Vorlesungsskript behandle ich unter anderem folgende Themen:
- Einführung in die lineare Regression und die logistische Regression (aber aus einer KI-Perspektive und nicht aus einer statistischen Perspektive)
- Maschinelle Lernverfahren wie Entscheidungsbäume, Neuronale Netze und Support Vektor Machines (SVM)
- Tuning Maschineller Lernverfahren (Leave-One-Out, Kreuzvalidierung)
- Bewertung von Prognosen durch geeignete Kennzahlen (z.B. Mean Absolute Error, Mean Squared Error, Sensitivität, Spezifität)
- Dimensonsreduktion
- Zeitreihen und Online-Learning
- Anomalieerkennung (one-Class-SVM) und Clustering (k-Means-Algorithmus)