Welcher Datentyp liegt vor?
Ich sage es in meinen Inhouse-Schulungen zur Datenanalyse immer: Das Wichtigste, das man jemals im Bereich der Datenanalyse oder Statistik lernen kann, ist die Frage nach dem Datentyp. Für jede Datenanalyse ist der Datentyp von zentraler Bedeutung, da das korrekte Vorgehen (Kennzahlen, Methodenwahl, grafische Darstellungen etc.) immer vom Datentyp abhängt.
In der Statistik-Vorlesung haben Sie vielleicht eine etwas längere Liste an Datentypen gelernt, aber ganz ehrlich: Wirklich relevant ist (fast immer) nur die Unterscheidung der drei Datentypen:
- nominal: Kategorien ohne Rangfolge
- ordinal: Kategorien mit Rangfolge
- metrisch: echte Zahlen
Nominale Daten: Kategorien ohne Rangfolge
Nominale Daten sind Daten, die aus festen Kategorien bestehen, wobei es keine strikte Rangfolge bei den Kategorien gibt. Ein klassisches Beispiel ist das Geschlecht: Es gibt drei feste Kategorien (weiblich, männlich, divers) und es gibt keine strikte Rangfolge, mit der sich die Kategorien sortieren lassen würden.
Nominale Daten bestehen sehr häufig aus Wörtern (wie z.B. weiblich, männlich, divers). Sehr häufig werden die Kategorien aber auch durch Zahlen kodiert (z.B. 1=weiblich, 2=männlich, 3=divers). Bei einer Zahlenkodierung stehen im Datensatz zwar Zahlen, aber es sind keine echten Zahlen. Aus diesem Grund ist der Zusatz „echte“ bei den metrischen Daten so wichtig. Zahlen sind nur dann metrische Daten, wenn es echte Zahlen sind. Bei einer Zahlenkodierung sind es nominale oder ordinale Daten.
Ordinale Daten: Kategorien mit Rangfolge
Ordinale Daten sind wie die nominalen Daten durch feste Kategorien gekennzeichnet. Der Unterschied ist nun aber, dass es bei den ordinalen Daten eine strikte Rangfolge bei den Kategorien gibt.
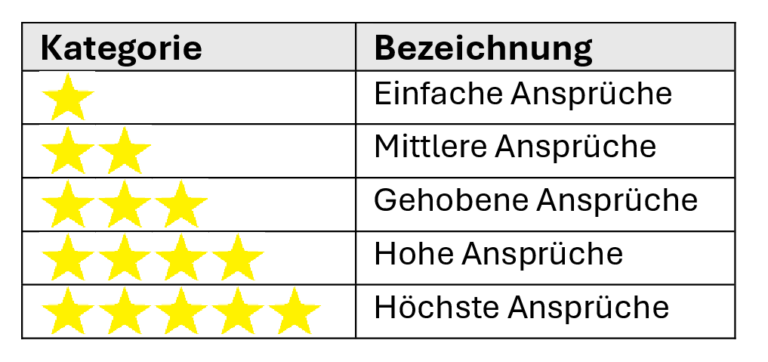
Ein schönes Beispiel für ordinale Daten sind die Größenangaben bei T-Shirts: XS, S, M, L, XL, XXL. Zweifellos handelt es sich hierbei um Kategorien und diese haben eine natürliche Reihenfolge (=Rangfolge) von klein (XS) bis groß (XXL). Ein weiteres Beispiel wäre das 5-Sterne-System der Hotelklassifizierung von einem Stern (für einfache Ansprüche) bis fünf Sterne (für höchste Ansprüche):
Metrische Daten: Zahlen, aber wirklich nur die echten!
Wie schon bei den nominalen Daten erwähnt, können alle Arten von Daten durch Zahlen kodiert werden. Als metrische Daten können aber nur echte Zahlen gelten. Echte Zahlen liegen vor, wenn die Zahl als solche eine inhaltliche Bedeutung hat. Dies trifft zum Beispiel typischerweise auf physikalisch messbare Größen zu: Länge, Volumen, Gewicht, Temperatur etc.
Das trifft aber zum Beispiel nicht auf Schulnoten im deutschen Notensystem mit Noten von 1 bis 6 zu. Hierbei handelt es sich um eine reine Zahlenkodierung: 1 = „sehr gut“, 2 = „gut“, etc. Schulnoten sind ein typisches Beispiel für ordinale Daten: es gibt feste Kategorien mit einer natürlichen Rangfolge von 1 (sehr gut) bis 6 (ungenügend). Dass die im deutschen Notensystem verwendeten Zahlen lediglich eine Zahlenkodierung darstellen und keine echten Zahlen sind, erkennt man auch daran, dass das amerikanische Notensystem stattdessen Buchstaben (von A bis F) verwendet. Oder denken Sie auch an das Notensystem in Hogwarts.
Tipp: Wenn Sie sich unsicher sind, ob es sich um echte Zahlen oder nur um eine Zahlenkodierung handelt, dann ersetzen Sie die Zahlen einfach durch Buchstaben in der Reihenfolge des Alphabets 1=A, 2=B, 3=C, etc. und überlegen Sie sich, ob das dann genauso (wie am Beispiel des Notensystems) funktionieren würde, oder ob durch die Umkodierung Information verloren gehen würde.
Das Ganze ist zugegebenermaßen manchmal ein wenig verwirrend, deshalb sehen wir uns nochmal ein paar lehrreiche Beispiele an.
Beispiele
Wir haben schon gesehen, dass Schulnoten im deutschen Notensystem ein Beispiel für ordinale Daten sind: Es gibt feste Kategorien mit einer natürlichen Rangfolge; die Kategorien sind durch Zahlen kodiert, aber es handelt sich dabei nicht um echte Zahlen.
Wie ist das aber zum Beispiel mit dem Baujahr von Gebäuden? Das Baujahr ist zum Beispiel ein wichtiger Einflussfaktor in einem Mietspiegel, wie ich ihn für Deggendorf entwickelt habe. Meine Schulungsteilnehmer vermuten häufig, dass das Baujahr ordinal wäre. Das Argument ist: Es gibt feste Kategorien (die einzelnen Jahre) und diese sind in einer natürlichen Reihenfolge geordnet. Aber nein! Das Baujahr ist in der Tat metrisch, denn es ist keine Zahlenkodierung, sondern eine echte Zahl, die als solche eine inhaltliche Bedeutung hat. Bei der Zahl 2019 handelt es sich zum Beispiel um die (physikalisch) gemessene Zeit (in Jahren), die seit dem als Nullpunkt definierten Zeitpunkt (Christi Geburt in unserer Zeitrechnung) vergangen ist. Dass wir Jahreszahlen nur gerundet als ganze Zahlen angeben, spielt dabei keine Rolle. (In real existierenden Datensätzen sind Zahlenangaben immer gerundet, manchmal auf ganze Zahlen, manchmal auf 2 Nachkommastellen, manchmal auf 30 Nachkommastellen, aber immer gerundet. Die Rundung kann also kein Argument sein.)
Ein sehr schönes Beispiel ist das Rauchverhalten, wie es zum Beispiel in einem Fragebogen erhoben werden könnte. Wenn es zum Beispiel die Ankreuzmöglichkeiten
- Ich habe noch nie geraucht.
- Ich habe früher geraucht, aber mittlerweile aufgehört.
- Ich bin aktiver Raucher.
gibt, dann würde es sich um nominale Daten handeln. Man könnte evtl. argumentieren, dass diese Daten auch als ordinal behandelt werden könnten, da es schon so etwas wie eine Rangfolge gibt. Das kann man so sehen, würde ich hier jedoch nicht empfehlen, weil die Rangfolge nicht so eindeutig ist, wie man vielleicht meinen könnte. (Tatsächlich ist es in Bezug auf den Gesundheitszustand so, dass die aktiven Raucher im Durchschnitt gesünder sind als die ehemaligen Raucher. Woran könnte das liegen?)
Wären im Gegensatz dazu die drei Antwortmöglichkeiten
- Nichtraucher
- mäßiger Raucher (bis 10 Zigaretten pro Tag)
- starker Raucher (mehr als 10 Zigaretten pro Tag)
dann wären es ganz klar ordinale Daten.
Wie wäre es aber, wenn stattdessen nach der Anzahl der durchschnittlich pro Tag gerauchten Zigaretten gefragt werden würde? Dann wären es metrische Daten, denn die Anzahl an Zigaretten ist eine echte Zahl und keinesfalls eine Zahlenkodierung!
Welche Daten sind die besten?
Welche Daten sind am besten: nominale, ordinale oder metrische? Das klingt nach einer etwas unsinnigen Frage, aber das ist es nicht. Als Statistiker kann ich hierauf eine ganz eindeutige und immer gültige Antwort geben: Metrische Daten sind die besten!
Der Grund ist, dass der Informationsgehalt von metrischen Daten am höchsten ist, dann kommen die ordinalen Daten und die informationsärmsten Daten sind die nominalen. Das hat zwei wichtige Konsequenzen, die wir uns im Folgenden anschauen:
Was darf ich mit welchen Daten?
Nur mit metrischen Daten darf gerechnet werden, denn bei ordinalen und nominalen Daten handelt es sich allenfalls um Zahlenkodierungen, und es macht keinen Sinn, mit willkürlichen Zahlenkodierungen zu rechnen. (Sie würden ja auch keine Durchschnitts-Telefonnummer ausrechnen.) Aus diesem Grund kann man den Mittelwert auch nur für metrische Daten, nicht aber für ordinale Daten berechnen. Echte Zahlen kann man auch der Größe nach sortieren, dementsprechend kann man bei metrischen Daten auch den Median angeben.
Die ordinalen Daten können immerhin aufgrund der Rangfolge noch sortiert werden, auch wenn nicht damit gerechnet werden darf. Aus diesem Grund ist für ordinale Daten die Angabe des Medians (beruht nur auf Sortieren) möglich, aber nicht die Angabe des Mittelwerts (beruht auf Berechnungen mit den Zahlenwerten.)
Bei nominalen Daten kann keine Sortierung und keine Berechnung mit den Werten durchgeführt werden. Es können nur noch Häufigkeiten angegeben werden.
Hier noch einmal die Zusammenfassung:
- metrische Daten: statistische Methoden dürfen Berechnungen, Sortierungen und Häufigkeiten verwenden
- ordinale Daten: statistische Methoden dürfen nur Sortierungen und Häufigkeiten verwenden
- nominale Daten: statistische Methoden dürfen ausschließlich Häufigkeiten verwenden
Aus dieser Zusammenfassung sieht man ganz deutlich, dass metrische Daten die reichhaltigsten Daten sind, mit denen man statistisch die meisten Möglichkeiten hat.
Downgrading ist immer möglich, Upgrading nie
Es wäre ein schwerer Fehler, wenn man nominale Daten wie ordinal behandeln würde, oder wenn man ordinale Daten wie metrisch behandeln würde. Denn dann würde man – wie wir eben gesehen haben – Dinge mit den Daten tun, die man nicht tun darf. Ein Upgrading beim Datentyp ist also nicht möglich! Umgekehrt ist ein Downgrading immer möglich: Ich kann metrische Daten ohne Weiteres wie ordinale Daten und ordinale Daten wie nominale Daten behandeln. Das bedeutet ja nur, dass ich auf Möglichkeiten (Berechnungen, Sortierungen) verzichte. Das mag im Einzelfall ungeschickt sein, aber es ist kein logischer Fehler.
Praxistipp: Bei Fragebögen empfehle ich immer, die Fragen möglichst so zu stellen, dass man metrische Daten erhält. Denn mit metrischen Daten kann man bei der statistischen Verarbeitung am meisten machen.
Und wenn die Daten erst einmal metrisch sind, dann kann man nachträglich immer noch Kategorien bilden. Das lässt sich sehr schön an unserem Zigarettenbeispiel sehen: Wenn ich meine Umfrageteilnehmer nach der durchschnittlichen Anzahl an Zigaretten pro Tag gefragt habe, dann kann ich hieraus problemlos Kategorien bilden:
- Nichtraucher (bei 0 Zigaretten pro Tag)
- mäßiger Raucher (bis 10 Zigaretten pro Tag)
- starker Raucher (mehr als 10 Zigaretten pro Tag)
Und noch ein Vorteil: Ich kann die Kategorien jederzeit noch ändern (zum Beispiel erst bei 15 Zigaretten die Schwelle zum starken Raucher setzen). Diese Möglichkeit habe ich nicht mehr, wenn ich die Kategorien schon in der Formulierung des Fragebogens gebildet habe.